AI エージェントを動かし始めると、ほどなく同じ問いに行き当たります。「これは、うまく動いていると言ってよいのか」。出力を何件か見て「悪くない」と思う。別の日に見ると、気になる箇所がある。精度を数字にしようとしても、何を分母にすればよいか決まらない。結局、担当者の感触で「まあ大丈夫そう」と続けるか、「不安だから全部人が見る」に戻るかのどちらかになります。先に結論を書きます。AI エージェントの評価とは、精度を測ることではなく、「任せてよい範囲を決めるための証拠を、決めた形で残す」ことです。精度は評価項目の 1 つにすぎず、評価の単位は「出力」ではなく「仕事」──結果・過程・止まり方・手間の 4 つで見ます。そして評価は、作る前に設計し、動かした後も続きます。この記事では、AI エージェントの評価とは何か、評価指標を 4 つの項目でどう置くか、作る前・本番・別の目の 3 層でどう評価するか、合格の例をどう集めて何件用意しどう更新するか、書く側と疑う側を分けて回している自社の型、そして評価でつまずく 3 つの型までを、明日から使える形で整理します。
- AI エージェントの評価とは、精度を測ることではなく、任せてよい範囲を決めるための証拠を、決めた形で残すこと ── 評価の単位は出力ではなく「仕事」
- 評価項目は 4 つ ── 結果・過程・止まり方・手間。精度は「結果」の一部にすぎず、精度だけで測ると過程と止まり方の事故が見えない
- 評価方法は 3 層 ── 作る前と変えるたびに「合格の例」を通す / 本番で差し戻しと例外を数える / 書いた側と別の目で疑う。層が 1 つでも欠けると、評価は感触に戻る
- 合格の例は作文せず本番から拾い、通る・落ちる・止まるの 3 種類をそろえ、手順書と対で版を持つ。件数は少なく始め、差し戻しのたびに 1 件足す
AIエージェントの評価とは ── 「答えの正しさ」ではなく「任せた仕事が回ったか」を確かめる
AI エージェントとは、目的を渡すと必要な手順を自分で組み立てて実行し、結果まで進める AI のことです(言葉の整理と仕組みは「AIエージェントとは」に 1 本にまとめています)。この「手順を自分で進める」という性質が、評価の難しさの出どころです。答えを返すだけの AI なら、評価は「答えが正しいか」で済みます。問いと正解を並べ、何件合っていたかを数えればよい。ところが仕事を進める AI では、評価したいものが「答え」ではなく「仕事が回ったか」に変わります。AI エージェントの評価とは、任せた仕事が、決めた範囲の中で、決めた止まり方をしながら、受け取れる形で終わったかを確かめることです。
「答える AI」の評価と「仕事を進める AI」の評価は、具体的には 3 つの点で違います。1 つ目、出力が揺れる。同じ入力でも、言い回しや手順の順番は毎回少しずつ違います。「正解と一字一句一致したか」では測れず、「観点を満たしているか」で測ることになります。2 つ目、途中がある。エージェントは何手も進みます。結果が合っていても、途中で触ってはいけない場所を読んでいたり、手順書に無い近道をしていたりすれば、それは次回の事故の予告です。結果だけを見る評価は、この途中を見落とします。3 つ目、外に作用する。書く・送る・動かす・消す。答える AI の誤りは「読んだ人が気づく」で済みますが、仕事を進める AI の誤りは、気づく前に外に出ていることがあります。だから評価には「止まるべきところで止まったか」という項目が要ります。
では、何のために評価するのか。品質を確かめるため、というのは半分です。もう半分は、任せる範囲を決めるためです。AI エージェントは「任せる・任せない」の 2 択ではなく、「どこまで任せ、どこで人が確認するか」の線で運用します。その線を動かす判断──もっと任せてよいか、いったん戻すか、止めるか──の材料が評価です。線の引き方そのものは「AIエージェントの管理」で「任せる範囲の決め方」として書きました。この記事はその判断に使う証拠を、どう作り、どう残すかの話です。評価の無いエージェントは、任せる範囲を広げられません。「なんとなく大丈夫そう」で広げた範囲は、「なんとなく不安」で全部戻ることになるからです。
ここで、「精度」という言葉を一度ほどいておきます。AI エージェントの精度を上げたい、という相談はとても多いのですが、精度と呼ばれているものの中身は、たいてい 1 つではありません。結果が合っているか、手順を守ったか、止まるべきところで止まったか、無駄な手数を踏んでいないか──これらが「精度が低い」の 1 語に束ねられています。束ねたまま精度を上げようとすると、モデルを替える・プロンプトを書き足す、という手しか打てません。精度は、4 つの評価項目に分けて初めて、どこを直せば上がるかが見えるようになります。次のセクションで、その 4 つを置きます。
評価指標は 4 つの項目で置く ── 結果・過程・止まり方・手間
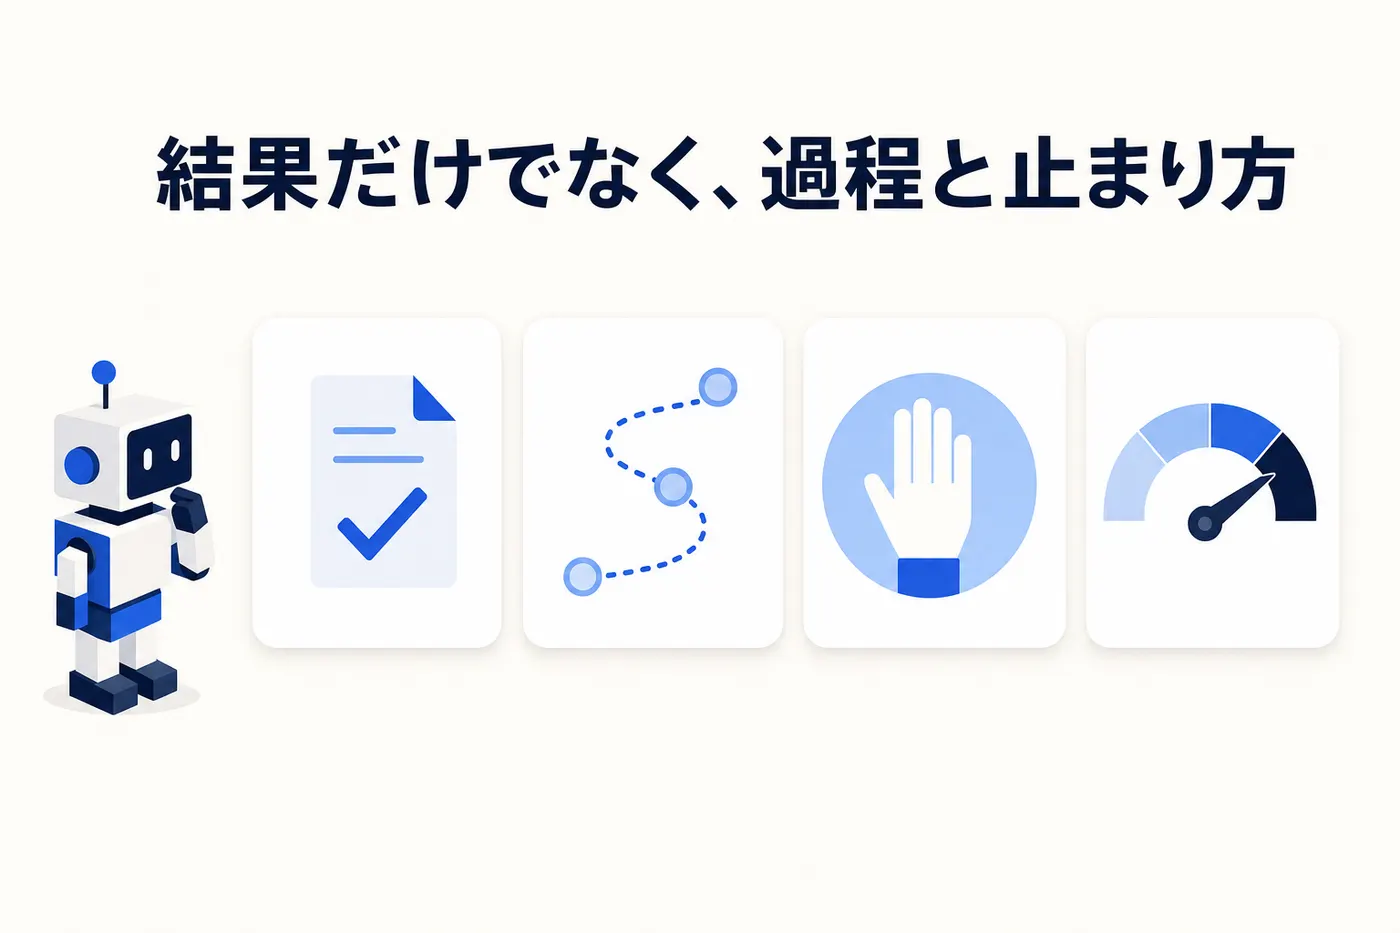
評価指標を決めるとき、最初から数字を探しに行かないでください。先に「何を見るか」を 4 つの項目に分け、それぞれに「どう数えるか」を後から当てます。項目が先、指標が後です。4 つの項目と、指標の置き方の型は次の表のとおりです。
| 項目 | 何を見るか | 指標の置き方(型) | 落ちているときの打ち手 |
|---|---|---|---|
| 1. 結果 | 出力が、合格の例と観点に照らして受け取れる形か | 人が確認して差し戻した件数と、その理由。合格の例を通したときに外れた例の数 | 差し戻しの理由を「手順書で潰せる / 潰せない」に分け、潰せるものは判断基準を 1 行足す |
| 2. 過程 | 決めた手順・道具・権限の中で進めたか | 手順書に無い動きをした件数。触ってはいけない場所に触ろうとした回数(権限で止まった記録) | 権限の線を仕組みで引き直す。「お願い」ではなく柵で止める |
| 3. 止まり方 | 止まるべき場面で止まり、人に戻したか。止めすぎていないか | 止まらずに進めた例外の件数。本来進めてよいのに止めた件数(止めすぎ)。戻し先に正しく届いた件数 | 止まる条件を手順書に書き足す。止めすぎは「進めてよい条件」を足して減らす |
| 4. 手間 | 使った量・時間と、人の確認にかかった手間 | 1 件あたりの確認時間。利用料と手数。確認待ちが溜まった件数 | 確認の形を「全件」から「例外だけ」へ。報告の形を固定して読む時間を減らす |
この 4 つのうち、一般に「精度」と呼ばれているのは項目 1 の一部です。「性能評価」という言葉で見られているのも、多くは項目 1 と項目 4 です。しかし運用で事故になるのは、項目 2 と項目 3 のほうです。結果はきれいなのに、途中で見てはいけないものを見ていた。結果は正しいのに、止まるべきところで止まらずに外へ出ていた。結果だけを見る評価では、この 2 つは「良い評価」のまま通り過ぎます。項目 2 の線を仕組みで引く方法は「AIエージェントのセキュリティ」に、項目 3 の「止まる場所」を業務に組み込む考え方は「生成AIのハルシネーション対策」の確認の関所に書きました。評価の項目は、この 2 本で立てた柵が「本当に効いているか」を数える役を担います。柵は立てただけでは効いているか分かりません。評価が、柵の点検です。
指標を数字にするときの注意を 2 つ。1 つ目、割合より先に件数と理由を取ること。母数が少ないうちは割合が大きく揺れ、増えた・減ったの判断を誤らせます。件数と理由 1 行を取っておけば、割合は後からいつでも出せます。2 つ目、数字に「どの版か」を添えること。手順書を直した前と後、モデルを替えた前と後では、同じ数字でも意味が違います。版の無い数字は、並べて比べられません。これは次のセクションの 3 層にも、合格の例の作り方にも、ずっと付いて回る原則です。
「精度が低い」の正体は、4 つの項目に分けると、たいてい次のどれかに落ちます。手順書の判断基準が曖昧で、同じ場面で毎回違う判断をしている(項目 1・結果の揺れ)。入力が乱れていて、手順書が想定していない形で入ってくる(項目 1 と項目 3・例外の増加)。合格の線そのものが曖昧で、確認する人によって差し戻しの基準が違う(項目 1・評価側の揺れ)。そして、本当にモデルの力が足りない(項目 1 で、手順書を直しても外れ方が変わらないとき)。精度向上の打ち手は、この切り分けの後で選びます。モデルを替えるのは、最後の 1 つに当たったときです。それより前の 3 つは、モデルを替えても同じ場所で外れます。
評価方法は 3 層 ── 作る前に通す・本番で数える・別の目で疑う
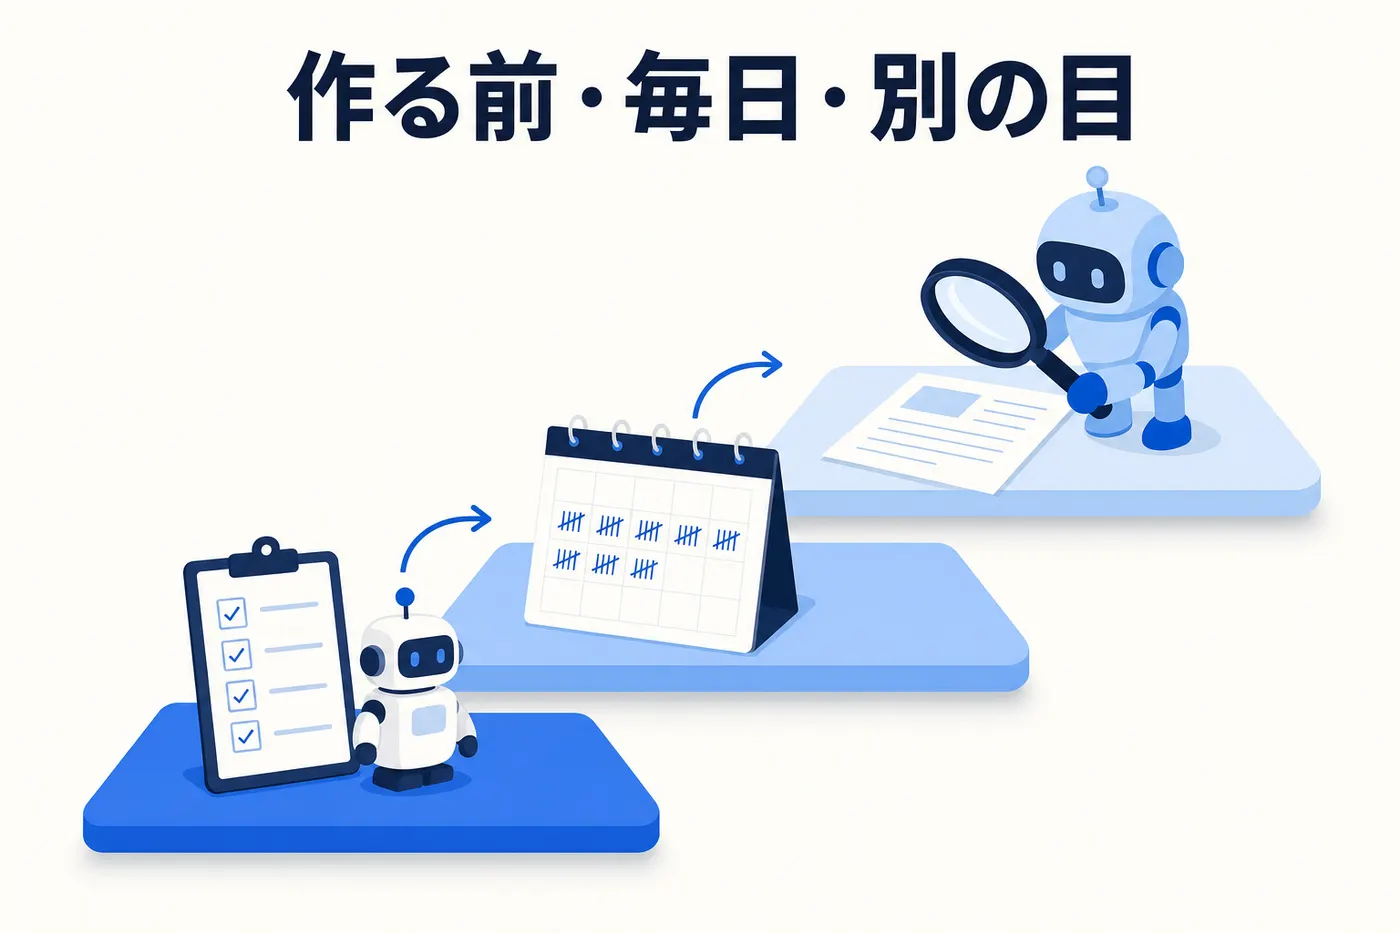
何を見るかが決まったら、いつ・誰が見るかです。AI エージェントの評価方法は 3 層で組みます。それぞれ見る時期も、見る人も、見つかる誤りの種類も違うので、どれか 1 つで代用はできません。
- ①合格の例を通す(作る前・変えるたび) ── 「この入力には、この観点を満たす出力が正しい」という例をあらかじめ用意し、エージェントに通して外れ方を見ます。見る人は作る側で構いません。見るのは主に項目 1(結果)と項目 3(止まり方)。この層の役目は「変える前と後を比べる」ことです。手順書を 1 行直した、モデルを替えた、道具を足した──そのたびに同じ例を全部通し、前は通っていたものが崩れていないかを確かめます。例が無いと、直すたびに「良くなった気がする」しか言えません。例の作り方は次のセクションで手順に落とします。
- ②本番で差し戻しと例外を数える(毎日・毎週) ── 合格の例を全部通っても、本番の入力は例より広い。だから本番で動かし始めた日から、人が差し戻した件数と理由、手順書に無い例外が出た件数、止まらずに進んだ件数を取ります。毎日見るのは「動いたか・止まったか」、毎週見るのは「差し戻しと例外の数と理由」。この層を誰が、どの頻度で持つかは、「AIエージェントの運用」で 4 つの仕事(確かめる・直す・測る・決める)として書きました。評価の側から言い直すと、この層は「合格の例を本番から補充する入口」です。差し戻された 1 件は、そのまま合格の例の候補になります。
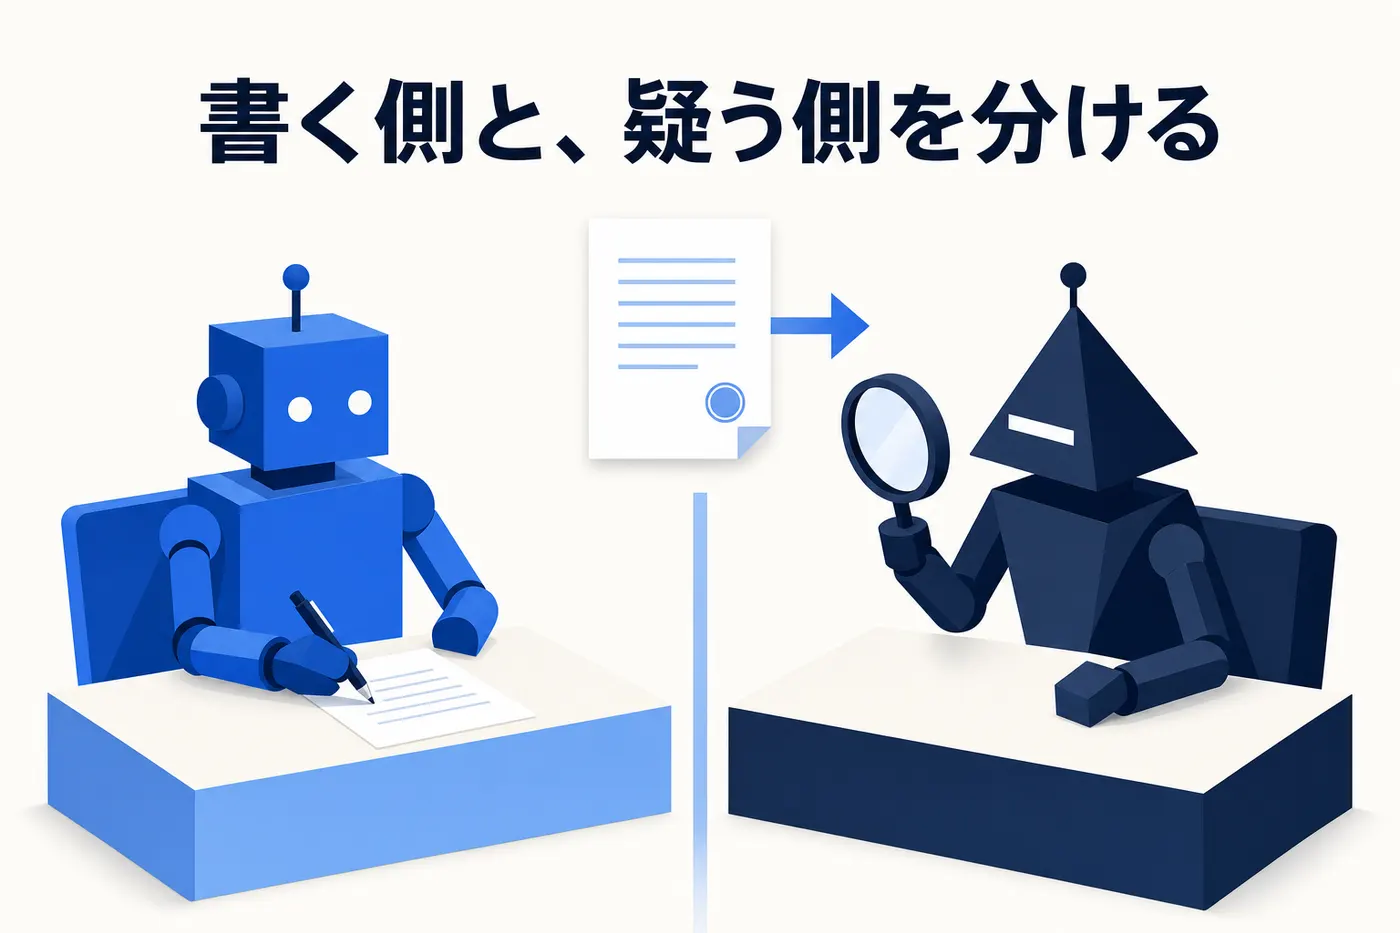
- ③書いた側と別の目で疑う(節目ごと) ── 層 ① と層 ② は、作る側・運用する側が自分で見ます。しかし、自分で書いた手順書・自分で選んだ合格の例には、自分の前提がそのまま入っています。前提が間違っていれば、例も手順書も同じ向きに間違っていて、通っているように見えます。だから節目ごと(本番に入れる前・任せる範囲を広げる前・外に出るものの前)に、書いた側とは別の目で疑う層を置きます。別の目は人でも、別の AI でも構いません。大事なのは「作った人・作った AI と同じ頭ではない」ことです。この層が見つけるのは、層 ① と層 ② では構造的に見つからない種類の誤り──前提そのものの誤りです。
「評価ツール」「評価フレームワーク」という言葉で探している方へ。道具が肩代わりしてくれるのは、層 ① の「例を通して外れ方を記録する」実行と、層 ② の「件数を集計する」部分です。4 つの項目を自分の業務の言葉で決めること、合格の例を本番から拾うこと、別の目を置くこと──この 3 つは、どんな道具を使っても自分で持つしかありません。道具を選ぶなら、見る問いは 3 つで足ります。合格の例を、自分の業務の言葉と形で持てるか(汎用の問題集ではなく)。結果に「どの版の手順書に対して通したか」を結びつけられるか。結果だけでなく、途中の動きと止まった記録を残せるか。この 3 つが「はい」なら、あとは使いやすさで選んで構いません。逆に、道具を入れれば評価が整う、という順番にはなりません。項目と例が先、道具は後です。
合格の例の作り方 ── 集め方・数・更新の 5 手順
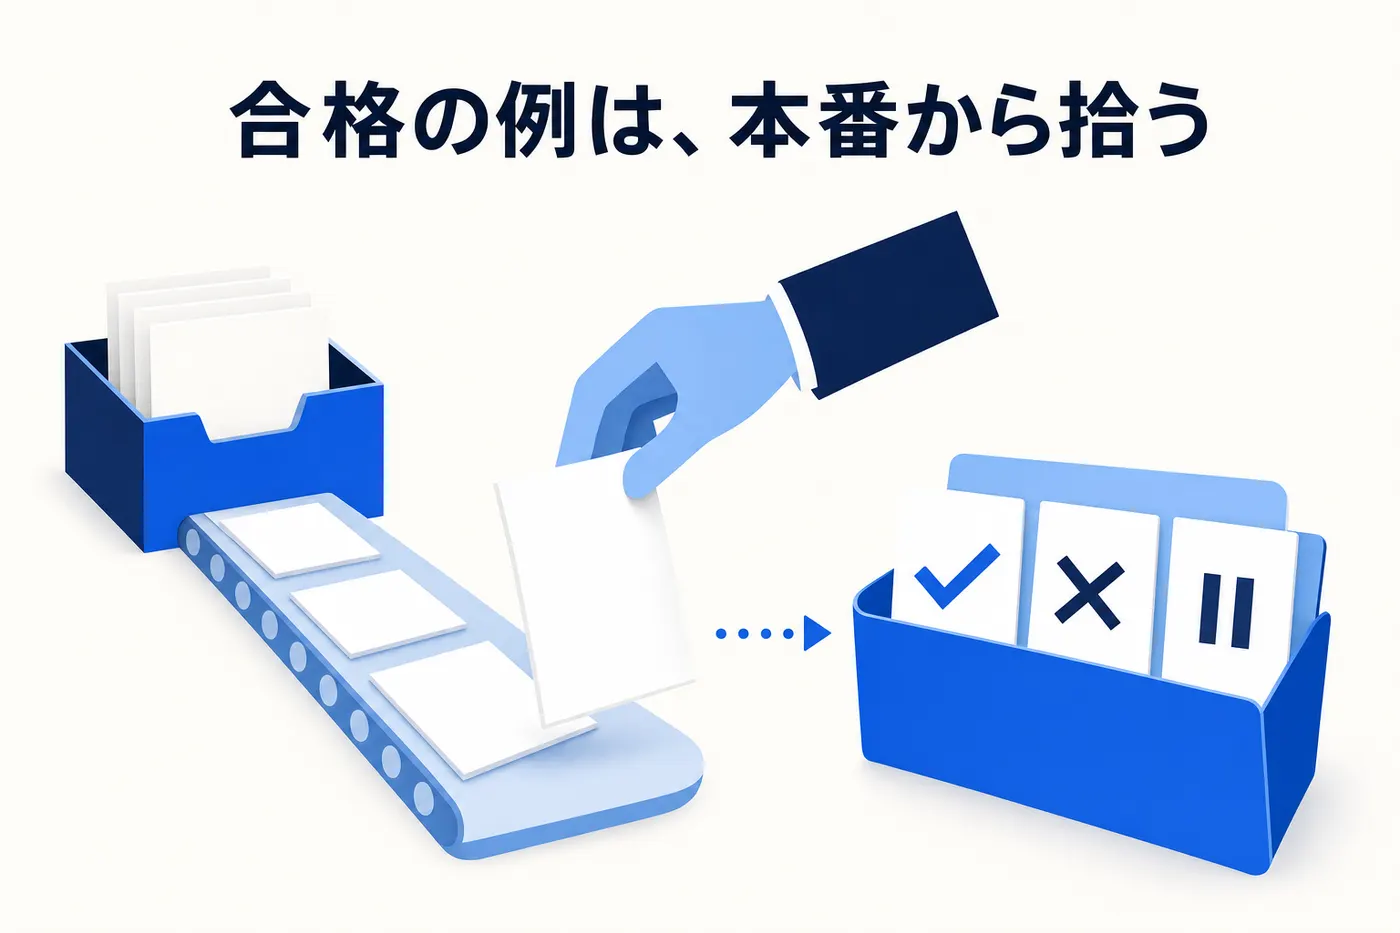
3 層の土台になるのが「合格の例」です。「AIエージェントの開発」では、開発の 5 段階の 4 つ目に「合格の例で試す」を置き、その集め方・数・更新は考え方に留めました。この記事で、手順に落とします。合格の例とは、「この入力には、こういう出力(あるいは、こういう止まり方)が正しい」という 1 組のことです。これが無いと、合格線は数字になりません。
手順 1 ── 本番の入力から拾う(作文しない)
合格の例の入力は、本番で実際に来たものから拾います。担当者が「こういう入力が来るだろう」と作文した例は、きれいすぎます。本番の入力には、空欄・表記ゆれ・添付の抜け・前提の省略が混ざっていて、エージェントが外れるのはたいていそこです。作文した例を全部通っても、本番で外れる理由がここにあります。拾い方は簡単で、過去に人がやっていたときの実物を、個人情報や機密を伏せたうえで、そのまま入力にします。まだ本番が始まっていないなら、人がやっている今の仕事から、直近の実物を数件もらってください。「典型的なもの」を選ぼうとしないこと。直近の、ありのままのものを取ります。
手順 2 ── 通る・落ちる・止まるの 3 種類をそろえる
合格の例というと「正しく処理できるべき例」だけを集めがちですが、それだけでは項目 3(止まり方)が評価できません。例は 3 種類そろえます。通る例(この入力には、この観点を満たす出力を返すべき)。落ちる例(この入力は、エージェントが処理してはいけない・手順書の範囲外である。処理せず人に戻すべき)。止まる例(途中まで進めてよいが、この場面で止まって確認を取るべき)。落ちる例と止まる例が無いと、「何でも処理してしまうエージェント」が満点を取ります。本番で事故になるのは、まさにその「何でも処理してしまう」挙動です。3 種類の比率に決まりはありませんが、落ちる例と止まる例が 1 件も無い例の集まりは、評価として片目をつぶっている状態だと思ってください。
手順 3 ── 合格は「一致」ではなく「観点」で書く
出力が揺れる AI に対して、合格を「この文章と一致すること」で書くと、言い回しが違うだけで不合格になり、評価が使いものになりません。合格は観点で書きます。「宛先の名前が入力どおりであること」「金額が転記されていて計算が合っていること」「断定の形で書いていないこと」「手順書に無い約束をしていないこと」のように、満たすべき点を箇条書きにし、全部満たせば合格とします。観点は、その業務で人が差し戻すときに見ている点を書き出せばよく、最初から網羅しようとしなくて構いません。差し戻しのたびに観点が 1 つ増えていきます。なお、一致で書けるものは一致で書いてください。「出力の件数が入力の件数と同じ」「ファイル名がこの形式」のように、揺れてはいけないものは一致で判定するほうが確実です。観点と一致を混ぜて使う、が実務の形です。
手順 4 ── 数は少なく始め、差し戻しのたびに 1 件足す
何件用意すればよいか、という問いには「最初は両手で数えられる数で十分」と答えています。件数より種類です。通る・落ちる・止まるが 1 件ずつでもあれば、評価は始められます。最初から何十件もそろえると、作るのに時間がかかるうえ、手順書を直すたびに全部通す手間が重くなって、通さなくなります。通さなくなった例は、無いのと同じです。増やし方は 1 つだけ。本番で差し戻しが出たら、その 1 件を例に足す。差し戻しは「本番の入力」で「人が不合格と判断した」実物なので、合格の例としてこれ以上の素材はありません。足すときは、どの観点で落ちたかを添えます。似た例が溜まってきたら、1 つにまとめて構いません。例の集まりは、業務の「外れやすい場所の地図」になっていきます。
手順 5 ── 手順書と対で版を持つ
合格の例は、手順書と対です。「どの版の手順書に対して、どの例が通ったか」を一緒に残します。手順書を 1 行直したら、例を全部通し直し、通った結果をその版に結びつける。これをしないと、ある日「前は通っていたはずの例が落ちる」が起きたときに、どの変更で崩れたかが追えません。手順書そのものの書き方──判断基準・禁止事項・出力形式をどう文章にするか──は「AIに渡す手順書の書き方」に書きました。評価の側から 1 つ足すなら、手順書の末尾に「この版で通した例」の一覧を持たせる、という形が簡単です。例の一覧が手順書の一部になっていれば、手順書を直す人は例を通さざるを得なくなります。仕組みで通させる、ということです。
注意を 1 つ。合格の例は、エージェントに「見せて覚えさせる」ためのものではありません。評価のための例を手順書に貼り付けると、エージェントは例に似た入力だけうまく処理し、例から外れた入力で崩れます。例は評価にだけ使い、手順書には例から取り出した判断基準を書く。この分け方を守ってください。
自社の型 ── 書く側と疑う側を分け、評価の線は実データで引き直す
Livune は、AI エージェントの開発・導入支援を行うと同時に、自社の日常業務を役割ごとの AI エージェントに任せて回している会社です。その中で評価の形がいちばんはっきりしているのが、このコラムの記事そのものです。実際の形を、評価の 3 層に沿って書きます。
記事を書くのは、執筆の担当のエージェントです。書き終えた記事は、まず機械の条件に掛けます。参照している画像が全部実在するか、本文中のリンク先が実在して開けるか、主な検索語の需要を生成時に確かめた記録があるか、効果を示す数字や他社の統計を借りていないか、禁止している表現が 0 件か、製品や社名に触れる文が製品の正本の範囲を超えて約束していないか。これが層 ① と層 ② に当たる部分で、人が読む前に機械が落とします。次に独立レビューです。書いた側とは別の AI モデルを使い、記事を初見で読んで、PASS・FAIL・要オーナー承認の 3 値で判定します。レビュー側は読むだけで、直しも承認も公開もしません。判定には「どの版の本文を読んだか」の指紋を添え、本文が 1 字でも変われば判定は無効になります。レビューの最後には、記事の内容とは別に 3 つの問いを必ず置きます。同じ主題の記事と並べて見劣りしないか。初めて来た読者がこの 1 本だけで動けるか。会社の判断軸と対外文書の原則に反していないか。これが層 ③、別の目です。
そのうえで、2026 年 10 月から、コラム記事の承認はオーナーの手を外しました。「人が最後に見る」をやめたのではなく、「人が見なくても止まる仕組み」がそろったので、外したということです。そろえた条件は 4 つ。機械の条件を全部通ること、独立レビューが FAIL でないこと、承認から公開までに 1 日の窓を置いて朝の報告に 1 行並べること(その日のうちに止めれば出ない)、そして撤退条件──自動で承認した記事に公開後の訂正が 1 回でも入ったら、承認制に戻す──を先に書いておくことです。開始から 30 日後に見直す日も決めてあります。なお、お金・人事・契約の判断は、この形でも委任していません。評価の仕組みで任せる範囲を広げられるのは、間違えても取り返しのつくものまでです。
この形を作る過程で、評価の線を引き直したことがあります。独立レビューを初めて実際の記事に当てたとき、PASS は 1 本も出ず、大半が「要オーナー承認」でした。理由を見ると、「自社の実践を書いている」が主でした。しかし、自社で任せた仕事と任せなかった判断をそのまま書くことは、このコラムの持ち味そのものです。線が厳しすぎて、持ち味がすべて人の承認待ちに回る形になっていました。そこでオーナーが「FAIL 以外は通す」に線を引き直しました。机上で引いた評価の線は、実データに当てて初めて、厳しすぎるか甘すぎるかが分かります。線を引き直すこと自体は悪くありません。結果を見てから黙って動かすのではなく、誰が・なぜ動かしたかを記録に残して動かす、が守るべきところです。
そして、別の目は実際に働いています。この記事の少し前に書かれた 1 本が、独立レビューで FAIL になりました。理由は、本文が自社の運用を実態より厳しく書いていたことです──承認を人で止めている、と。書いた側は、自分が持っていた古い前提をそのまま文章にしていて、その前提が古いことに自分では気づけませんでした。合格の例を通しても、機械の条件を通しても、この誤りは見つかりません。前提そのものの誤りは、別の目にしか見えないからです。作る役・試す役・疑う役を分けて回す形は、「ソフトウェアテストのAI活用」でも自社の運用として書きました。書く側と疑う側を同じ頭にしないことは、評価の形の中でいちばん効いている 1 点です。
AIエージェントの評価でつまずく 3 つの型
最後に、評価がうまく回らないときの型を 3 つ挙げます。どれも「評価をしていない」のではなく、「評価をしているつもりで、見るべきものを見ていない」形です。
「結果が合っていた件数」だけを追い、過程と止まり方を見ない型です。数字は良く見えるのに、ある日、途中で触ってはいけないものに触っていた・止まるべきところで止まらず外に出ていた、が見つかります。見つかった時点で「評価はしていたのに」と感じますが、評価の項目に入っていなかったのです。打ち手は、項目 2 と項目 3 の指標を、件数が少なくてもよいので取り始めること。0 件が続くなら、それ自体が「柵が効いている」証拠として残ります。
手順書を書いた人が、合格の例を選び、通して、合格を出す型です。悪意はありません。ただ、自分の前提に沿った例を選び、自分の前提に沿った観点で採点するので、前提の誤りは通り抜けます。上に書いた自社の例がまさにこれで、書いた側は自分の古い前提に気づけませんでした。打ち手は、節目ごとに別の目を置くこと。人でも別の AI でも構いません。「別の頭か」だけが条件です。疑う役を別のエージェントに持たせるときの線の引き方は、別の記事で改めて扱う予定です。
本番に入れる前に一度だけ評価し、その後は手順書を直してもモデルを替えても例を通さない型です。直すたびに「良くなった気がする」だけが積み上がり、ある日、前は通っていたものが落ちていると分かる。いつから落ちていたかは分かりません。打ち手は、手順 5 の「手順書と対で版を持つ」を仕組みにすること。手順書の末尾に例の一覧を持たせ、直したら通す、を手順書自身に書いておきます。そして本番の差し戻しを例に足し続けること。評価は、動かした後も続く仕事です。
評価が回り始めると、人の手元に残る仕事は「確認待ちの件数を見て、裁く」に収れんしていきます。その手元の設計──承認者には何が届き、何を見て、どれだけの時間で裁くのか──は、評価とは別の 1 本として書く予定です。 この記事で持ち帰っていただきたいのは、評価項目を 4 つに分けること、合格の例を本番から拾って手順書と対で持つこと、そして書く側と疑う側を分けること、の 3 つです。
Livune は、「作業を AI に任せる仕組み」を構築している会社です。任せた仕事を評価の形ごと設計し、任せる範囲を証拠で広げる──これは私たちが自社の仕事に対して置いている決まりでもあります。書く側と疑う側を分け、線は実データで引き直し、撤退条件を先に書く型は、私たちが自分の会社でも使っているものです。
Livune は、本番で回ることを前提に AI エージェントを設計・構築する会社です。任せる 1 業務の選定から、評価項目・合格の例・独立レビューの置き方まで、この記事に書いた順番をそのまま御社の業務に当てはめるところからご相談ください。
Livune の AI エージェント導入について相談する →よくある質問
先に項目を決め、指標は後から当ててください。項目は結果・過程・止まり方・手間の 4 つで、それぞれ「人が差し戻した件数と理由」「手順書に無い動きをした件数」「止まらずに進んだ件数と止めすぎた件数」「1 件あたりの確認時間」のように、件数と理由 1 行から始めます。割合は母数が溜まってから出せば足ります。全部を一度に取るのが重ければ、結果と止まり方の 2 つから始めてください。
無くても始められます。道具が肩代わりするのは、合格の例を通して記録する実行と、件数の集計です。評価項目を自分の業務の言葉で決めること、合格の例を本番から拾うこと、別の目を置くことは、道具を入れても自分で持つ部分です。選ぶなら、自分の業務の形で例を持てるか、どの版の手順書に対する結果かを結びつけられるか、途中の動きと止まった記録を残せるか、の 3 点で見てください。
件数より種類です。通る例・落ちる例・止まる例が 1 件ずつでもあれば評価は始められ、最初は両手で数えられる数で足ります。増やし方は、本番で差し戻しが出るたびにその 1 件を足すこと。差し戻しは本番の入力で人が不合格と判断した実物なので、これ以上の素材はありません。最初から数十件そろえると、手順書を直すたびに通す手間が重くなり、通さなくなります。通さない例は無いのと同じです。
「精度が低い」をほどくところからです。手順書の判断基準が曖昧で同じ場面の判断が揺れているのか、入力が手順書の想定外の形で来ているのか、合格の線が曖昧で確認する人によって基準が違うのか、手順書を直しても外れ方が変わらない(モデルの力の限界)のか。差し戻しの理由を 1 行ずつ見ると、たいていどれかに落ちます。モデルを替えるのは最後の 1 つに当たったときで、それより前の 3 つはモデルを替えても同じ場所で外れます。