AI エージェントを業務に入れたい。けれども「勝手にファイルを消したりしないか」「お客様の情報が外に漏れないか」「間違ったメールを送ってしまわないか」──この不安が消えないまま、検討が止まっている会社は少なくありません。そして相談を受けたとき、私たちがよく目にする対策が「プロンプトに『削除してはいけない』『社外に送ってはいけない』と書く」というものです。気持ちは分かりますが、これは柵ではありません。この記事でお伝えしたいのは、AI エージェントのセキュリティは、AI の賢さや指示文の言い回しではなく、「権限」「自己点検」「人の確認」の 3 層で作るものだということです。権限で「できない」を構造として作り、その柵が生きているかを動く前に確かめ、人の目は全件ではなく例外に集める。この 3 層は AI を使わないための壁ではなく、安心して任せる範囲を広げるための土台です。生成AI チャットの利用と何が違うのかから始めて、読む・書く・動かす権限から来るリスクの正体、権限で作る具体的な方法、柵の自己点検、ヒューマンインザループの設計、データの扱い、そして小さく始める順番まで、順に整理します。
- AI エージェントのリスクは賢さの問題ではなく「読む・書く・動かす」の 3 つの権限を持つことから来る ── だから対策も権限から始める
- 「やってはいけない」をプロンプトに書くのは努力目標であって柵ではない ── 「できない」は OS やアカウントの権限で作る(読むだけの口座、書く先は専用フォルダ、削除は実装に入れない)
- 柵は立てた日から変わっていく ── 動く前に自分で柵を点検し、想定と違えば処理せず止まる仕組みが、免責より先に要る
- 人の確認は全件に置くと形骸化する ── 正常系は機械の検査に持たせ、人の目は例外に集めるのが機能するヒューマンインザループ
AIエージェントのセキュリティは、生成AIチャットの利用と何が違うのか
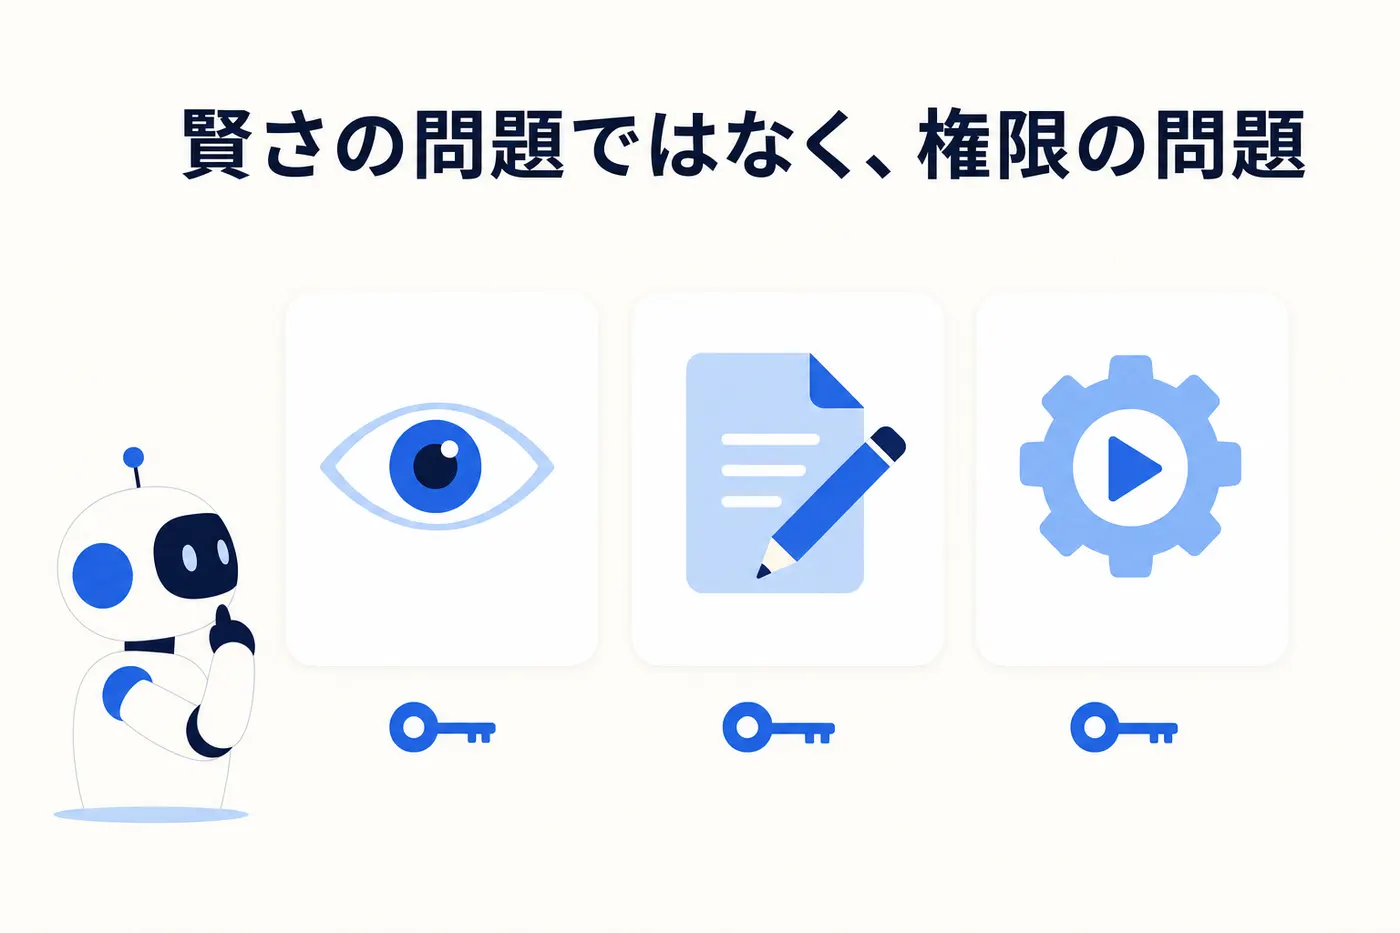
まず、なぜ AI エージェントになると「セキュリティ」の話が急に重くなるのかを押さえておきます。生成AI チャットを社内で使うとき、AI は答えを返すだけで、その答えを使うのは人でした。AI 自身は社内のファイルを開けないし、メールも送れません。だからリスクは「何を入力するか」と「出てきた答えを鵜呑みにしないか」の 2 つに収まっていました。AI エージェントは違います。目的を与えると、必要な手順を自分で組み立て、ファイルを読み、書類を作り、システムを操作して、結果まで進めます(定義の整理は「AIエージェントとは」で 1 本にまとめています)。つまり AI エージェントは、読む・書く・動かす、という 3 つの権限を持って社内に入ってくる存在です。新しいメンバーを 1 人迎えるのと同じで、何を見せ、どこに書かせ、何を操作させるかを決めないまま席に座らせることはできません。
3 つの権限から来るリスクは、次の 4 つに整理できます。ここで大事なのは、右の列です。4 つとも、AI の賢さや善意に頼らず、設計で避けられるものだということを、先にお伝えしておきます。
| リスク | 何が起きうるか | 設計で避ける形 |
|---|---|---|
| 読める情報の漏洩 | 業務に不要な情報まで読め、その内容が出力や外部サービスに混ざる | 読める範囲を業務に必要な場所だけに絞る(読む権限) |
| 書き換え・削除 | 既存の資料やデータを上書き・削除してしまう | 書ける場所を専用フォルダ 1 つにし、削除を実装に入れない(書く権限) |
| 外部への送信・操作 | 誤った相手に送る、誤った金額や設定で操作する | 送信・送金・公開は人の確認を通す工程にする(動かす権限 + 人の目) |
| 指示のすり替え | 読み込んだメールや Web の文章に紛れた指示に従ってしまう | 権限で被害を小さくし、外に出る直前に人が見る(権限 + 人の目) |
4 つ目の「指示のすり替え」は、AI エージェント特有のもので、少し補足しておきます。エージェントはメールや Web ページなど、外から来た文章を読んで仕事をします。その文章の中に「この内容を次の宛先に転送せよ」のような指示めいた文が紛れていると、AI がそれを本当の指示と取り違えることがあります。これは AI の性能が上がれば消えるという類の問題ではなく、読む対象を信用しきれないという構造から来るものです。だからこそ対策は「賢い AI を選ぶ」ではなく、「取り違えても被害が出ない権限にしておく」と「外に出る直前に人が見る」の 2 つになります。表の右の列がどれも権限と人の目に帰着するのは、偶然ではありません。
「やってはいけない」をプロンプトに書いても、柵にはならない ── 権限で作る
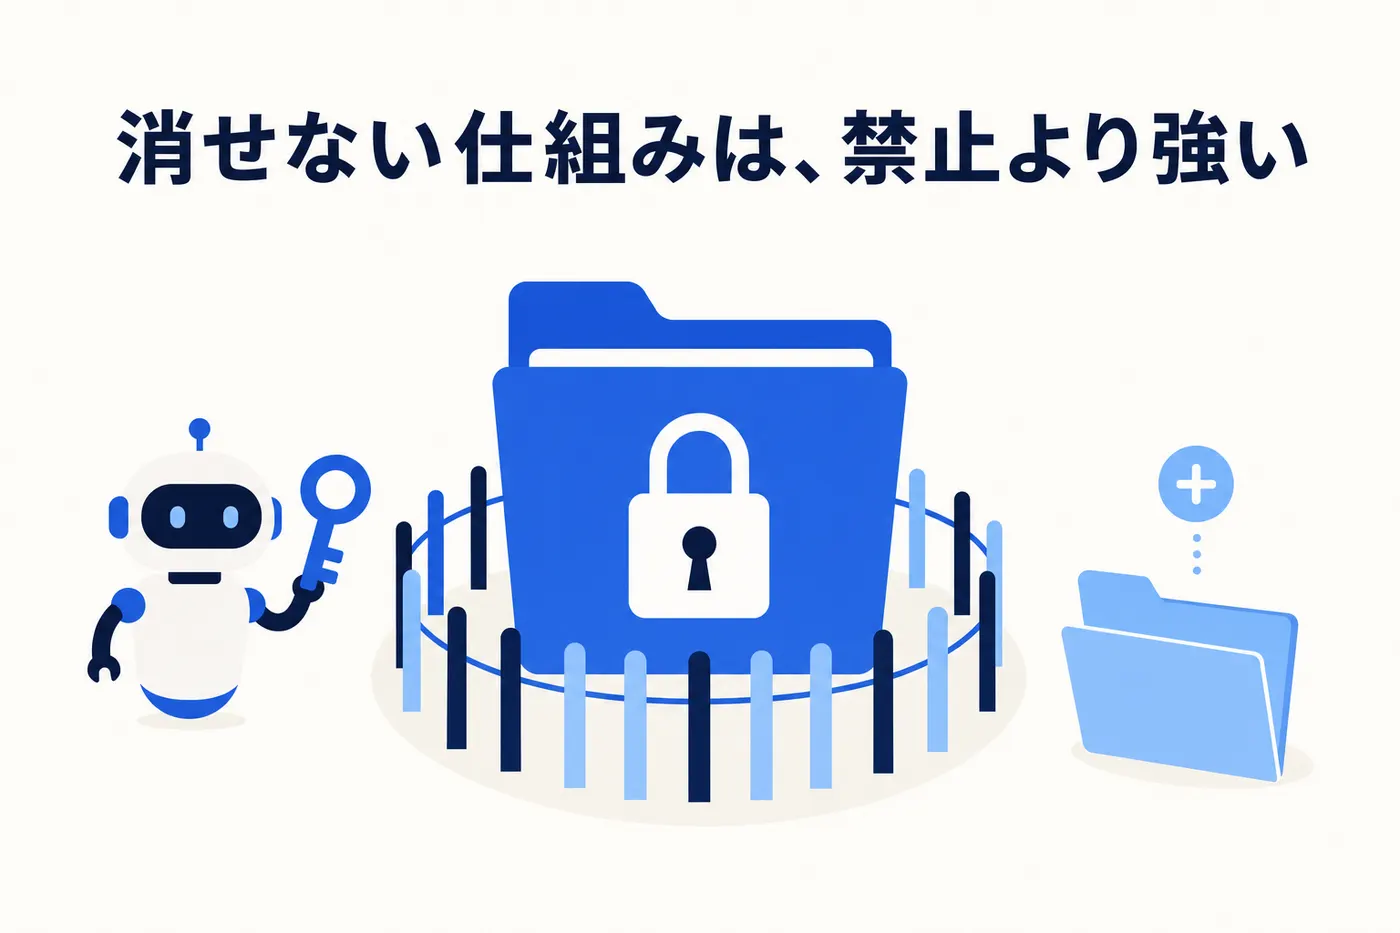
最初に、いちばん多い誤解を解いておきます。「削除してはいけない」「社外に送ってはいけない」と手順書やプロンプトに書くこと自体は、大事です。AI に渡す手順書に判断基準と禁止事項を書き切る型は「AIに渡す手順書の書き方」で詳しく扱いました。ただし、それは「守ってほしいこと」を伝える手段であって、「できないこと」を作る手段ではありません。文章による指示は、状況によって解釈が揺れます。前の章で見たとおり、外から読んだ文章に紛れた指示に上書きされることもあります。「消すな」と書いてあっても、消せる権限を持っていれば、消える可能性はゼロにはなりません。逆に、消す権限が無ければ、AI がどれだけ賢くても、どんな指示を受けても、OS が拒否します。「暴走して削除」は、正しく権限を組めば起きない事象です。プロンプトの言い回しに頼らず、権限で「できない」を作る──これが 1 層目です。
ここで、AI の話から少し離れます。私たち自身、取引前の相手先から「連絡用に」と社内チャットの招待を受けて入ってみたら、外部ゲスト用の入口ではなく通常メンバーとしての招待で、全社のチャンネルがそのまま見える状態だった、という経験があります。担当者に悪気はなく、招待の種類を取り違えただけでした。責めるべきは担当者ではなく、間違えて招待できてしまう構造を放置していたことです。AI に権限を渡す前に、人間の招待権限すら設計されていない会社は珍しくありません。そして AI の権限設計は、この延長線上にあります。私たちは業務委託のメンバーを含む全員に自社ドメインのアカウントを配り、社内はドメインで閉じ、外部の方とは別の入口でやり取りしています。人に対してこの二段を作れているかどうかが、AI に対して同じことを作れるかどうかの下地になります。
読む権限 ── 読み専用の口座で、業務に必要な場所だけ
AI エージェントに社内のデータベースやファイルを読ませるとき、人が使っている ID をそのまま渡していないでしょうか。人の ID には、その人が持つすべての権限が付いてきます。エージェントには専用のアカウントを発行し、読み取り専用にし、読める範囲を業務に必要なフォルダやテーブルに絞るのが基本形です。専用アカウントにする理由はもう 1 つあり、「誰が何をしたか」が記録で区別できるからです。人の ID を共用すると、事故が起きたときに人の操作か AI の操作かが分からなくなります。読む範囲を絞ることは、次の章で扱う「データの漏洩」への対策そのものでもあります。読めないものは、漏れようがありません。
書く権限 ── 書く先は専用フォルダ 1 つ、新規作成と追記のみ
書く権限は、いちばん慎重に設計する場所です。原則は 3 つあります。
- ①書き込み先は AI 専用のフォルダを 1 つだけ用意し、そこ以外には書かせない。成果物の置き場が 1 か所に決まるので、人が受け取る側の運用も単純になります。
- ②その中でも新規作成と追記のみにして、上書きと削除の操作を実装に入れない。「消せる道具」を最初から渡さなければ、消すなという指示は要らなくなります。
- ③既存の業務フォルダには、OS の権限設定で削除と変更を明示的に拒否する。「書き込みはできるが削除はできない」という設定は、一般的な OS で実際に作れます。
この 3 つが揃うと、AI が生成した成果物は必ず専用フォルダに溜まり、人がそこから取り出して使う、という流れになります。既存のデータが壊れる経路が構造的に無くなるので、「消すな」と何度も書く必要も、消していないか毎回確かめる必要もなくなります。
動かす権限 ── 管理者にしない、取り返しのつかない操作は実装から外す
エージェントを動かすアカウントに、管理者権限を付けないでください。管理者権限は「何でもできる」権限であり、それを持たせた時点で、前の 2 つの設計が意味を失います。加えて、送金・契約の確定・公開・一括削除のような取り返しのつかない操作は、そもそも AI が呼べる道具として実装に入れないか、入れるなら人の承認を経ないと実行されない工程にします。ここは「AI に何ができるか」ではなく「AI に何を持たせるか」の問題で、道具を 1 つ渡すごとに「これは取り返しがつくか」を問う、という習慣に落とし込むのが実務的です。判定の軸は、その操作で業務が止まるか、他者の資産に触れるか、元に戻せるか、の 3 つで足ります。
私たち自身の運用も、この形です。自社の業務を回している AI エージェントは、書き込める場所を専用のフォルダに限定し、削除の操作を実装に持たず、業務に必要な最小限の権限で動いています。そのうえで手順書には「やってほしいこと」と「判断に迷ったらどうするか」を書いています。手順書は仕事の質を上げるためのもので、事故を防ぐのは権限の仕事──役割を分けると、両方が軽くなります。
柵は、動く前に自分で確かめる ── 止まれる仕組みと証跡
権限で柵を立てたら、それで終わりにしたくなります。しかし柵は、立てた日から少しずつ変わっていきます。誰かが「一時的に」共有設定を広げてそのまま戻し忘れる。システムの更新で権限の既定値が変わる。便利だからと、書き込める場所を 1 つ増やす。どれも悪意のない日常の出来事で、しかも気づきにくい。柵が外れたことに誰も気づかないまま、AI が毎日動き続ける──これがいちばん避けたい状態です。だから 2 層目として、AI エージェントが動き出す前に、自分の柵が想定どおりかを自分で点検し、違っていれば処理をせずに止まって知らせる仕組みを入れます。「書き込み先は専用フォルダだけか」「既存フォルダの削除は拒否されているか」「アカウントは管理者ではないか」──この確認を定時の処理の冒頭に置き、1 つでも想定と違えば、その回は何もせずに終了して担当者に通知する。動けなくなる方向に倒れる設計なので、柵が外れたまま動き続ける事故は構造的に消えます。
この自己点検には、事故を防ぐ以外に 3 つの効き目があります。
- ①「止まった」という事実が、異変の第一報になる。柵の変更は静かに起きるので、人が見張り続けるのは現実的ではありません。AI が止まって知らせてくれるなら、変更に気づく仕組みを別に作る必要がありません。
- ②変更の記録が客観的に残る。いつ、どの設定が想定と違ったかがログに残ります。後から「誰がいつ変えたか」を辿るとき、この記録が起点になります。
- ③責任の話が、感情でなく事実でできる。外部のパートナーに構築を頼んだ場合、設定が変わった後に起きたことは誰の責任か、という論点が必ず出ます。点検の記録が無いと、この話は水掛け論になります。記録があれば、事実を並べて話せます。
運用上のコツを 1 つ添えると、「止まった」を失敗として扱わないことです。点検で止まるのは、柵が仕事をした瞬間です。止まった回を責める文化があると、現場は点検を緩める方向に動きます。止まったら設定を確かめて戻し、なぜ変わったかを 1 行残す──それだけで、この層は長く生き続けます。
ヒューマンインザループの設計 ── 人の確認は「全件」ではなく「例外」に置く
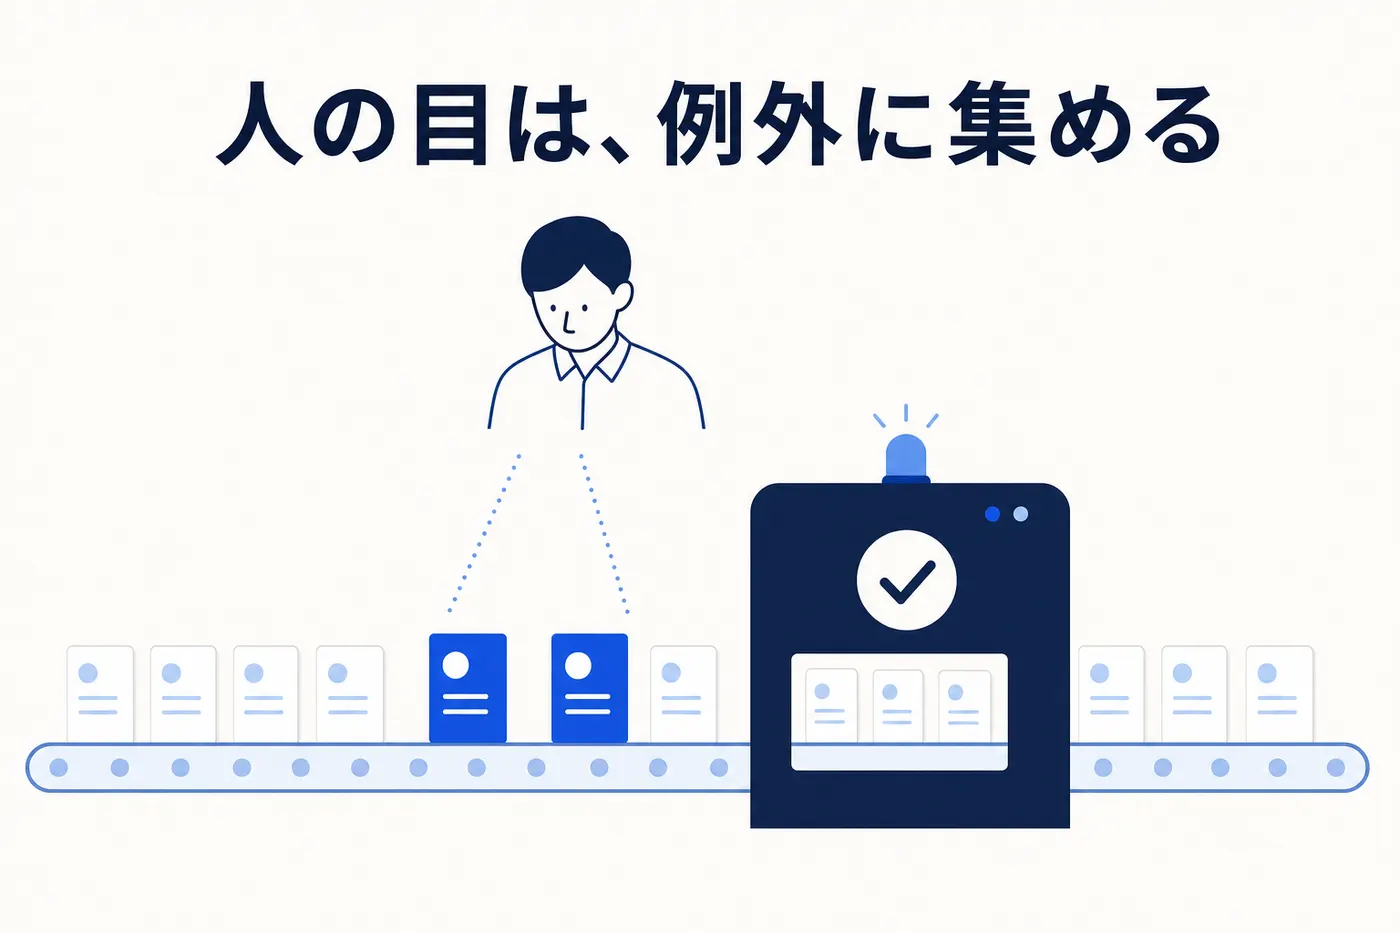
3 層目は人の確認です。AI の判断や操作の流れの中に人の確認を組み込むことを、ヒューマンインザループ(人が輪の中にいる)と呼びます。AI 導入の文脈でよく聞く言葉ですが、実務で大事なのは「人の確認を入れるかどうか」ではなく、どこに、どの形で入れれば機能するかです。というのも、人の確認は置き方を間違えると、安全装置ではなく儀式になるからです。
典型的な失敗は、こうです。たとえば、AI が取引先ごとに書類を作って自動で送付する仕組みを組むとします。安全側に倒すつもりで、送付の直前に承認画面を置き、その日の送付分をすべて人が確認して承認ボタンを押す設計にする。教科書どおりに見えますが、実際に運用すると、毎日何十件もの書類を 1 件ずつ開いて確かめることは続きません。数日で「ざっと見て全部承認」になり、やがて「見ずに承認」になります。しかも「承認した」という事実だけは残るので、誰も見ていないのに、見た形になる。これがいちばん危ない状態です。人の注意は希少な資源で、全件に薄く延ばすと、どこにも効かなくなります。
では、どう置き直すか。まず、本当に避けたい誤りは何かを 1 つに絞ります。書類の送付なら「送ってはいけない相手に送る」の一方向であることがほとんどです。すると、その誤りを防ぐのは人の目視より、機械の照合のほうが強いことに気づきます。送付停止の一覧との突き合わせ、宛先の形式の検査、件数が想定の範囲内かの確認──これらは全件に対して機械が毎回同じ精度でやれます。そのうえで、人が見るのは機械が「例外」と判定したものだけにします。判定の確度が低いもの、宛先の確認が要るもの、件数が異常な日。画面には、なぜ例外になったかの根拠が 1 行で出るようにして、ログを読み込まなくても判断できる形にします。人の確認が機能する条件は、次の 3 つに整理できます。
- ①見る対象が絞られている。正常系は機械の検査に持たせ、人の前には例外だけが来る。1 日に人が見る件数が、集中して見られる量に収まっていることが前提です。
- ②判断材料が 1 画面にある。「なぜ例外なのか」「元の情報はどれか」が、その場で見える。別のログや別の画面を開かないと判断できない確認は、確実に飛ばされます。
- ③差し戻しが仕組みの改善に返る。人が直した内容が、手順書や判定の条件に反映される。差し戻しが「その場の修正」で終わると、同じ例外が毎日来て、確認する側が疲れます。
そして、人の関与は段階的に薄くしていきます。最初の期間は全件を人が能動的に承認し、機械の判定の精度を実測する。差し戻しの割合が事前に決めた水準を下回ったら、「人が止めなければ進む」形に切り替える。さらに安定したら、例外だけを人が見る形に移す──この 3 段階を、最初から計画に書いておきます。仕上げに 1 つ、差し戻しがゼロの状態が続いたら、それ自体を疑うという検知を仕込んでください。差し戻しゼロは「完璧に動いている」か「誰も見ていない」かのどちらかで、外からは区別がつきません。週に数件、無作為に抜き取って人が確かめる監査を置くと、この 2 つが区別できます。任せる範囲と確認点をどう決めるかの全体像は「AIエージェント導入の進め方」のステップ 2 で、出力の誤りそのものを事故にしないための業務側の組み立ては「生成AIのハルシネーション対策」で、それぞれ扱っています。
データの扱い ── 読ませる範囲と、出ていく先を決める
「AI エージェント セキュリティ」で調べている方の多くが、いちばん気にしているのはデータの漏洩だと思います。ここまでの 3 層と重なる部分もありますが、データの観点で改めて整理しておきます。決めることは 2 つ、何を読ませるかと、読んだものがどこへ出ていくかです。
読ませる範囲については、権限の章で書いたとおり、業務に必要な場所だけに絞るのが基本です。加えて、個人情報やお客様の機密を含む業務では、AI に渡す前に名前や固有の情報を伏せ字にする工程を挟む、対象外の項目は最初から読ませない、という 2 段構えにします。読ませなければ、出力にも外部にも混ざりません。出ていく先については、まずエージェントがどの外部サービスに何を送っているかを一覧にすることから始めます。AI モデルの提供元だけでなく、翻訳、検索、メール送信など、道具として組み込んだサービスすべてが「出ていく先」です。一覧にすると、意図せず社外に出ている経路が見つかることがあります。
AI モデルの提供元に対しては、契約の形態を確認してください。法人向けの契約形態では、入力した内容をモデルの学習に使わないことが契約上の条件として定められているのが一般的です。一方、個人向けの利用形態ではその保証が設定や条件に依存する場合があります。業務で本格的に使うなら、「学習に使われない条件になっているか」を、機能の比較より先に確かめるのが順番です。そして最後に、エージェントが何を読み、何を出力し、どこへ送ったかの記録を一定期間保管します。記録は事故を防ぐものではありませんが、何かあったときに「何が出たのか」を事実で答えられるかどうかを分けます。人が生成AI チャットを使う際に「入力してよい情報の範囲」をどう決めて共有するかは「生成AIの社内ガイドラインの作り方」で扱っており、エージェントの読ませる範囲を決めるときにも同じ考え方が使えます。
セキュリティを理由に止まらないために ── 読むだけから始め、取り決めを4点持つ
3 層を全部きれいに揃えてから始めようとすると、いつまでも始まりません。順番があります。最初に任せる業務は、読むだけで完結するものを選んでください。資料の要約、問い合わせの分類、報告書の下書き、データの突き合わせと差分の一覧化──AI が読んで、専用フォルダに書き出し、人が受け取って使う。この形なら、書く権限は専用フォルダ 1 つ、動かす権限は不要で、1 層目の設計はほとんど自動的に満たされます。読むだけの業務で運用が回り、点検が生き、人の確認の置き方が固まってから、書き込みを伴う業務、そして外部への操作を伴う業務へ、順に広げていきます。セキュリティは「最初に完璧にするもの」ではなく、任せる範囲を広げるたびに、1 段ずつ厚くしていくものです。
もう 1 つ、構築を外部のパートナーに頼む場合に持っておきたいのが、責任の取り決めです。ここまでの 1 層目・2 層目が実装に入っていることを前提に、契約や合意の中で次の 4 点を決めておくと、後から揉めにくくなります。
- ①柵の設定を、片方の判断で変えない。構築側が設置した権限やアクセス制御を、利用側が同意なく変更しない。変更した後に起きたことの責任は、その変更に紐づく──この一文があるだけで、2 層目の点検記録が意味を持ちます。
- ②バックアップの責任を明確にする。データの取得は誰が、確認は誰が行うか。どれだけ権限を絞っても、バックアップは事故のときに最後に効く保険であり、導入前に有無を確かめることは、構築側の誠実さの実体でもあります。
- ③責任の範囲と上限を書く。「全責任を負います」は守れない約束で、かえって信用されません。責任は限定したうえで、何かあったときの復旧には原因を問わず協力する──賠償と復旧協力を分けると、誠実さと現実性が両立します。
- ④成果物は人の確認を前提とした補助である、と明記する。最終的な採否と確定の操作は利用側が行う。3 層目の設計を、そのまま合意の言葉にしたものです。
この 4 点は、パートナーを疑うためのものではなく、お互いが同じ絵を見て進めるためのものです。1 層目と 2 層目が無いまま契約の免責条項だけを厚くしても、実際の事故は防げませんし、設定が変わったことを証明できなければ条項は機能しません。権限 → 自己点検 → 取り決めの順に組み立てるのは、そのためです。
Livune は、「作業を AI に任せる仕組み」を構築している会社です。私たち自身の業務を回している AI エージェントは、この記事の 3 層──書ける場所を専用フォルダに絞り、無人で動く処理は冒頭で柵を点検して違えば止まり、人の目は例外に集める──で毎日動いています。お客様の環境に AI エージェントをお納めするときも、契約の条文より先に、権限と自己点検が実装に入っているかを確かめるところから始めています。
Livune は、この記事の 3 層(権限・自己点検・人の確認)を自社の業務で毎日運用し、お客様の現場でも「何を読ませ、どこに書かせ、どこで人が見るか」から一緒に設計している AI エージェント開発・導入支援の会社です。安心して任せる範囲を、本番運用前提で広げていきます。
Livune の AI エージェント導入について相談する →よくある質問
書くこと自体は大事ですが、それは「守ってほしいこと」を伝える手段で、「できないこと」を作る手段ではありません。文章の指示は解釈が揺れ、外から読み込んだ文章に紛れた指示に上書きされることもあります。削除や送信の権限そのものを持たせなければ、どんな指示を受けても OS が拒否します。プロンプトは仕事の質のため、権限は事故を防ぐため、と役割を分けてください。
設計の「判断」は経営者や業務担当が持てます。何を読ませてよいか、どこに書かせるか、どの操作は人が確認するか──これは業務の話であって技術の話ではないからです。設定の「実装」は、社内の情シスや外部のパートナーに頼んで構いません。その際、この記事の 3 層と取り決め 4 点を渡し、「読み専用の口座」「書く先は専用フォルダ 1 つ」「動く前に柵を点検して違えば止まる」が実装に入っているかを確認事項にしてください。
渡す前に 3 点を確かめてください。契約の形態が法人向けで入力内容をモデルの学習に使わない条件になっているか、読ませる範囲を業務に必要な場所に絞って個人情報や機密は伏せ字にするか対象から外しているか、そしてエージェントがどの外部サービスに何を送っているかを一覧にしているか、です。この 3 点が揃えば、決めた範囲の中で安心して任せられます。範囲を決めずに「念のため使わない」に倒れるのが、いちばん多い損失です。
まず、削除できる権限を持たせず、送信の直前に人の確認を置いていれば、その事故は構造的に起きにくくなります。そのうえで、外部パートナーと構築する場合は、柵の設定を片方の判断で変えないこと、バックアップの責任、責任の範囲と上限、成果物が人の確認を前提とした補助であること、の 4 点を事前に取り決めておきます。設定が変わっていないかの点検記録があれば、責任の話を感情ではなく事実でできます。