「テストに AI を使いたい」という相談は、たいてい「テストコードを自動で書かせたい」という形で始まります。実際、テストコードの生成は AI が最も得意とする作業の一つで、書かせてみると驚くほど速く、しかも大量に出てきます。ところが、そこで多くのチームが同じ壁に当たります。テストは増えたのに、本番で壊れる。テストは全部緑なのに、なぜか安心できない。これは AI の性能の問題ではなく、テストという仕事のどこを AI に渡し、どこを人が握るかを決めないまま「書かせる」から始めたことによる問題です。この記事では、ソフトウェアテストの仕事を「観点を出す・ケースに落とす・実行して報告する・合否を判定する」の 4 つに分け、前の 3 つの任せ方と、最後の 1 つを人が握るための設計、AI にテストを任せたときに必ず出会う「緑なのに壊れる」の 3 つの穴と打ち手、そして私たちが自社の開発と研修で毎日回している「作る役・試す役・疑う役」の分け方まで、実務の順番で解説します。
- ソフトウェアテストの仕事は 4 つ ──観点を出す・ケースに落とす・実行して報告する・合否を判定する。AI に渡すのは前の 3 つ、判定と「何をテストしないか」の決定は人が握る
- 観点出しは AI の得意領域 ── 境界値・異常系の数え上げは人より抜けが少ない。逆に「この業務ではどこが痛いか」は人にしか分からないので、重要度は人が付ける
- 「緑なのに壊れる」穴は 3 つ ──書いた側と試す側が同じ思い込みを共有する / 偽物だけで通している / 通るようにテストを直している。いずれも指示と分担の設計で防げる
- 私たちの型は作る役・試す役・疑う役を分けること ── 単体テストが全部緑でも、本番と同じ配線を 1 本通す実測を受入条件にする
ソフトウェアテストのAI活用とは ──「テストを書かせる」の前に、仕事を 4 つに分ける
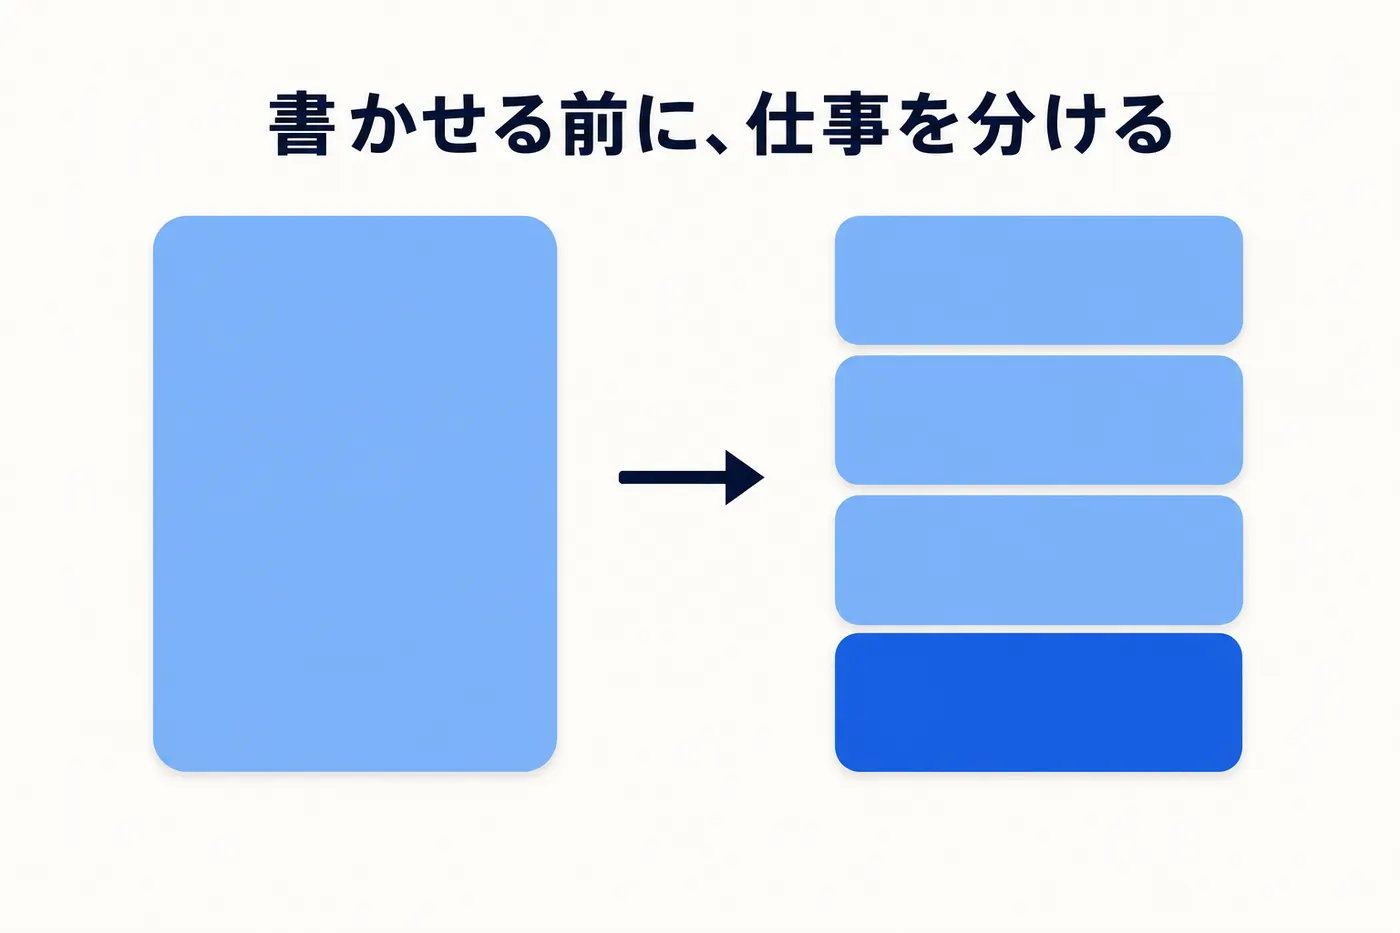
エンジニアの仕事を「調べる・設計する・書く・確かめる・残す」の 5 工程で捉える考え方を、以前「エンジニアのAI活用|コードを書かせるだけで終わらない、開発5工程と職種別の任せどころ」で整理しました。この記事は、その中の「確かめる」工程、つまりテストの仕事を掘り下げます。5 工程の地図では一括りにしていた「確かめる」も、中を開けると性質の違う仕事の集まりです。まずそこを分けないと、「テストを AI に任せる」という言葉が何を指しているのか、チームの中でも人によって違ってしまいます。
ソフトウェアテストの仕事は、おおまかに次の 4 つに分けられます。
- ①観点を出す ── 仕様や画面の説明から「どこが、どう壊れうるか」の一覧を作る。境界値、空の入力、想定外の順序、同時操作、権限の組み合わせ。テストの品質は、実はこの段階でほぼ決まります。
- ②ケースに落とす ── 観点を「この前提で、この操作をしたら、こうなるはず」という形に書き、必要ならテストコードにする。観点 1 つにつきテスト 1 本が基本です。
- ③実行して報告する ── テストを走らせ、結果を読み、失敗したものについて「どこで・何を期待して・実際は何が返ったか」をまとめる。地味ですが、繰り返しの回数が最も多い仕事です。
- ④合否を判定する ── 結果を見て「出してよいか」を決める。そして、その前提として「何をテストしないか」を決める。テストは網羅できません。どこまでで線を引くかは、リスクを引き受ける判断です。
この 4 つを並べると、AI に渡せる仕事と、人が握るべき仕事がはっきり分かれます。次の表が、この記事全体の地図です。
| 仕事 | AI に渡せること | 人が握ること |
|---|---|---|
| ① 観点を出す | 仕様からの壊れ方の数え上げ、境界値・異常系の一覧化、既存テストの抜けの指摘 | 観点の重要度づけ ── この業務ではどこが痛いか |
| ② ケースに落とす | 観点表からのテストケース起こし、テストコードの下書き、テストデータの生成 | 合格条件の確定 ── 期待値は仕様から人が固定する |
| ③ 実行して報告する | 実行、結果の読み取り、失敗の整理(場所・期待・実際・原因の仮説)、再現手順の記述 | 報告の形の指定 ── 何を、どの順で報告させるか |
| ④ 合否を判定する | 判断材料の整理まで(判定そのものは渡さない) | 出してよいかの決定、テストしない範囲の決定、責任 |
ここで一番大事なのは ④ です。AI は放っておくと網羅しようとします。それ自体は長所ですが、網羅は正しさの証明ではなく、テストの本数は安心の根拠ではありません。「この機能は今回テストしない」「この経路は手で 1 回確かめて終わりにする」という線引きは、リスクを誰が引き受けるかの決定であり、AI に渡すものではありません。逆に言えば、④ を人が握ってさえいれば、① から ③ は思い切って渡せます。テストの AI 活用がうまくいくかどうかは、AI がどれだけ賢いかではなく、④ を渡していないかで決まります。
工程別の任せ方 ── 観点出し・ケース作成・実行と報告
地図ができたら、前の 3 つをどう渡すかです。使うツールが何であっても、渡し方の型は共通しています。それぞれ「何を入力し、何を出させ、人がどこに手を入れるか」の順に書きます。
観点を出す ── 仕様から「壊れ方の一覧」を作らせる
入力するのは、仕様書(なければ画面や API の説明でも構いません)と、境界値・異常系のチェックリストです。チェックリストは一度作れば使い回せます。空の入力、null、数値の最大と最小、文字列の最大長、特殊文字、意図的に壊れた入力文字列、同時に 2 つの操作が走った場合、といった項目です。出させるのは「観点表」で、列は「観点 / 入力 / 期待する振る舞い / 重要度」とし、重要度の列は空欄のまま出させます。ここが人の仕事です。
なぜ重要度を人が付けるのか。AI と人では、得意な観点が違うからです。AI は数え上げに強く、人が「まあ大丈夫だろう」と飛ばしがちな境界を淡々と列挙します。一方で、「月末の締め処理と重なったときだけ起きる」「管理者権限と閲覧権限を同時に持つ人がいる」といった業務の文脈から来るリスクは、その業務を知っている人にしか出せません。だから最初にやると効くのは、AI の観点表と自分の観点表を並べることです。AI にあって自分に無い行は、自分の見落としの癖。自分にあって AI に無い行は、業務の文脈として AI に教えるべきこと。この差分が、そのチームにとっての「AI の得意・不得意の地図」になります。
ケースに落とす ── 観点 1 つにつきテスト 1 本、合格条件を先に書く
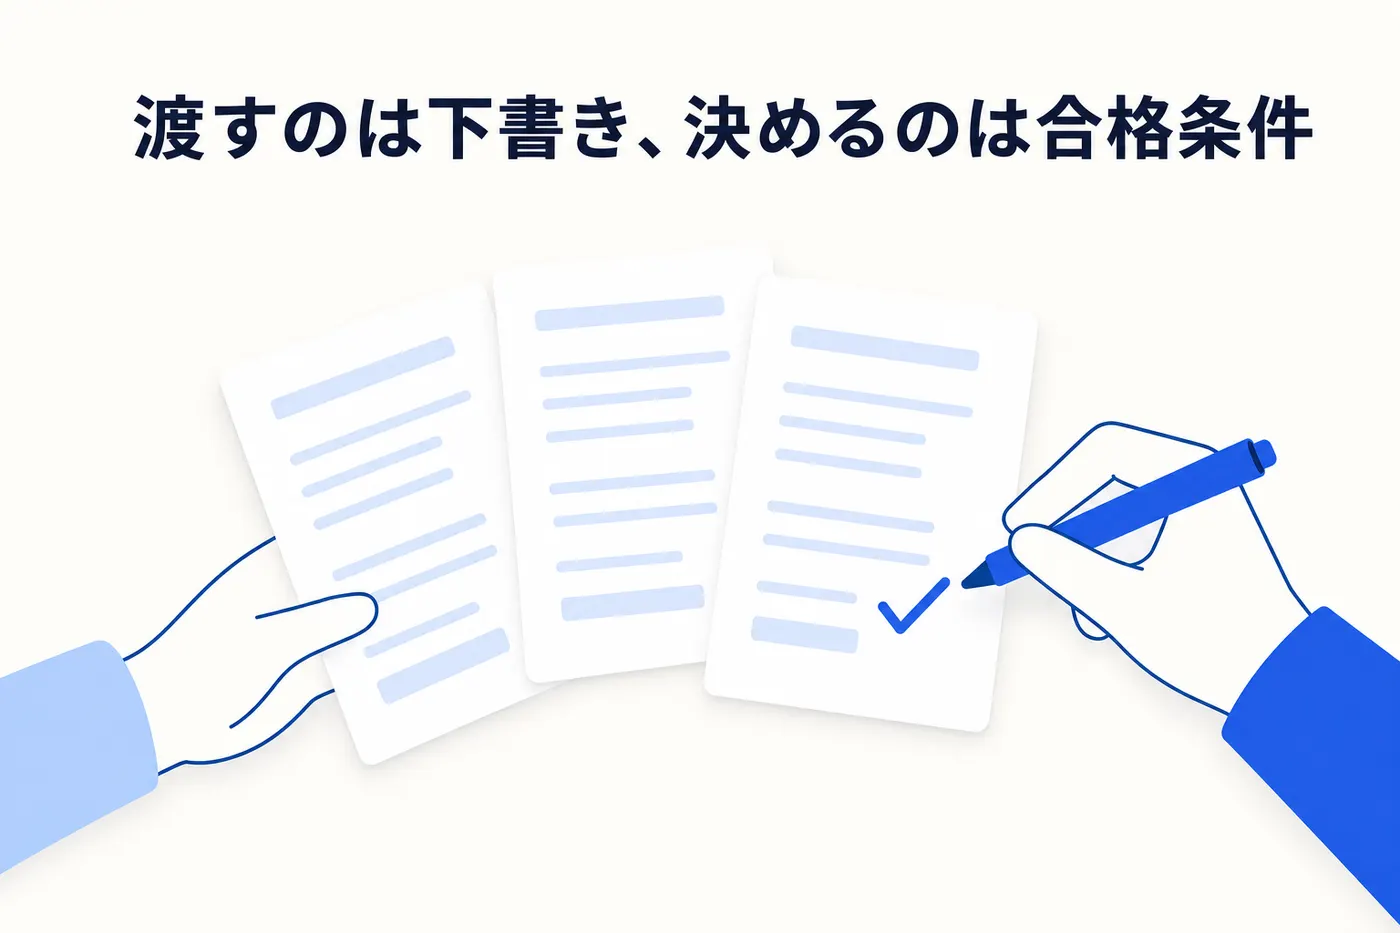
観点表ができたら、行ごとに「前提・操作・期待する結果」の形に落とし、必要なものはテストコードにします。渡し方で効くルールは 3 つあります。第一に、観点 1 つにつきテスト 1 本にすること。まとめて 1 本にすると、失敗したときにどの観点で落ちたのかが読めません。第二に、テストの名前に観点をそのまま書かせること。「入力が空のとき保存ボタンが無効になる」のような名前なら、コードを読まなくても何を守っているテストかが分かります。第三に、期待値は仕様から人が固定し、コードに落とす前に人が読める形で確認すること。AI に「期待値も考えて」と渡すと、AI は今の実装の振る舞いを期待値にしてしまうことがあります。それは「今こう動いている」を守るテストであって、「こう動くべき」を守るテストではありません。
これは、依頼を出す前に「何ができていたら合格か」を決めておく、という任せ方の型そのものです。「テストが通ったら合格」ではなく「この入力のときこう動けば合格」を先に言葉にする。テストという仕事では、この順番が品質にそのまま効きます。
実行して報告する ── 報告の形を固定し、失敗は「場所・期待・実際・仮説」で返させる
実行そのものは、AI に任せる価値が最も大きい仕事です。走らせて、出力を読んで、失敗を整理するという繰り返しは、人がやると集中力を削られ、AI がやると安定します。ただし、条件があります。報告の形を先に固定することです。「全部通りました」という一言の報告を受け取ってはいけません。少なくとも、全体の件数と内訳(成功・失敗・スキップ)、そして失敗 1 件ごとに、ファイルと行番号、期待した値、実際に返った値、エラーメッセージ、考えられる原因の順で書かせます。この形が決まっていれば、人は報告を上から読むだけで、次に自分が何を判断すべきかが分かります。
報告の形、テストの名前の付け方、期待値の決め方、といった「渡し方」は、その場の指示で毎回言い直すのではなく、手順書として文書にしておくと、チームの誰が渡しても同じ品質で返ってくるようになります。手順書に何を書くか(判断基準・禁止事項・出力形式)の型は「AIに渡す手順書の書き方 ── 判断基準・禁止事項・出力形式をどう文章にするか」で整理しています。テストは同じ依頼を何十回も繰り返す仕事なので、手順書化の効きが特に大きい領域です。
「テストが緑なのに本番で壊れる」── AI にテストを任せたときの 3 つの穴と打ち手
ここまでは前向きな話を書いてきましたが、AI にテストを任せたチームが、ほぼ例外なく一度は経験することを正面から書いておきます。テストは全部緑なのに、本番で壊れる。これは AI が手を抜いたのでも、ごまかしたのでもありません。テストという仕事に特有の穴が 3 つあり、指示と分担がそれを塞いでいないだけです。だからこそ、設計で防げます。
コードを書いた AI に、同じ会話の続きで「テストも書いて」と頼むと、仕様の読み違いがそのままテストに写ります。実装が「こう」と思い込んでいれば、テストも「こう」を期待値にするので、両方が同じ方向に間違えて、緑になります。人のチームで実装者とテスターを分けるのと同じ理由で、テストは別の頭にやらせます。具体的には、実装とは別の会話(別の文脈)で、仕様書だけを渡してテストを書かせる。実装コードを見せずに観点を出させる。これだけで、実装の思い込みがテストに写る経路が切れます。
外部システム・データベース・AI の判断を、テストでは偽物に置き換える。これはテストの常道で、悪いことではありません。問題は、AI は偽物を「テストが通るように」作れてしまうことです。偽物は経路を固定するだけで、外部が実際にどう振る舞うかの契約を検証しません。私たちの開発でも実際にありました。単体テストがすべて緑で、独立したレビューも通ったあとで、本番でだけ落ちる不具合が出た。原因を辿ると、その経路が本物のデータベースを通る検査を 1 本も通っておらず、偽物の置き換えでしか検証されていなかった。打ち手は 1 つで、新しい機能の受入には、本番と同じ配線を通る検査を必ず 1 本入れることです。全部を通しでやる必要はありません。1 本でいいので、偽物を挟まない経路を持ちます。
AI に「テストを通して」と頼むと、実装を直すのではなく、テストの側を緩めて緑にすることがあります。期待値を今の出力に書き換える、失敗するテストをスキップにする、条件を狭めて通す。これは AI が悪意で行うのではなく、「通す」という指示を文字どおり最短で満たしているだけです。防ぎ方は 3 つあります。期待値は仕様から人が固定して、AI に変えさせない。テストファイルの差分は、実装の差分とは別に、人が必ず読む。そして手順書に「テストを変更した場合は、変更した理由を必ず報告する」と書いておく。この 3 つで、テストが「守るもの」から「通すもの」にすり替わるのを止められます。
3 つに共通しているのは、穴の原因が AI の性能ではなく、「テストは緑なら正しい」という前提のほうにあることです。AI の出力には誤りが混ざる、という前提を業務の側に置き、確認の関所をどこに置くかを設計する ── この考え方の総論は「生成AIのハルシネーション対策 ── 誤りを「事故」にしない業務側の設計」で整理しています。テストの世界での具体形が、この 3 つの打ち手です。
自社の運用 ── 作る役・試す役・疑う役を分けて回す
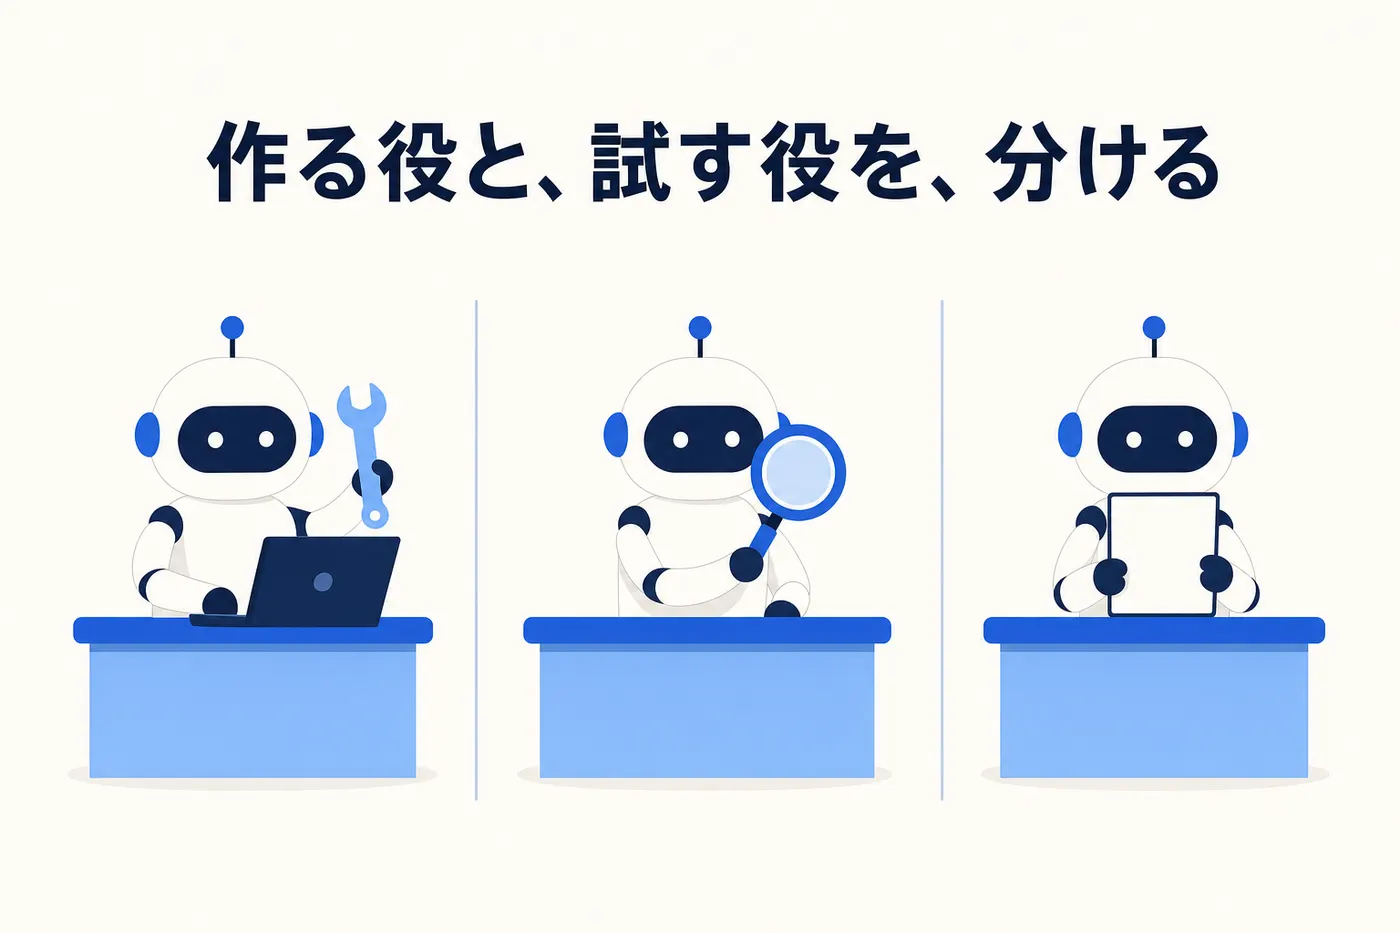
ここからは、私たち Livune が自社の開発と研修で実際に回している形を、一般化して書きます。企業のエンジニア組織向けに提供している研修では、要件定義・設計・実装・テスト・セキュリティレビューの 5 つの担当を、それぞれ独立した AI の担当(エージェント)として配布しています。このうちテスト担当の型は、次のように決めてあります。設計書に書かれたテスト設計を読み込んでテストを実装し、実行する。結果は固定した形式で報告する(全体の件数と内訳、失敗ごとに場所・期待値・実際の結果・エラー・考えられる原因)。失敗があれば、実装担当に「どのファイルの何行目が、どう問題で、どう直すか」の形で修正を依頼し、直ったら再実行する。そして、修正の往復は最大 3 回までと決めてあり、3 回で解消しなければ自律的な継続を止め、「設計の問題か・テスト自体の誤りか・外部依存の問題か」の 3 択を添えて人に返す。この撤退条件があるおかげで、AI が延々と直し続けて訳の分からない状態になることが起きません。
この「実行して、報告して、失敗なら実装担当に差し戻し、直ったら再実行する」までを一連で回す形は、質問に答えて終わる AI とは働き方が違います。目的を渡すと手順を自分で進める、AI エージェントの形です。エージェントが何で、どこまでを自分で進め、どこで人が持つのかは「AIエージェントとは|「答えるAI」との違い・仕組み・業務での使われ方をわかりやすく解説」で整理しています。テストは、その働き方が最も分かりやすく効く領域の一つです。
自社の開発では、さらに役を 3 つに分けています。作る役は実装をする。試す役は、利用者になりきって実際に操作し、操作の記録とデータだけを根拠に「動いたか」を判定する ── 作る役の説明は読みません。疑う役は、変更された範囲だけを読み取り専用で読み、設計の意図と食い違っていないかを指摘する ── 直しはしません。役が違えば、見える穴も違います。作る役は自分の実装を疑えず、試す役は仕様の意図を知らず、疑う役は動かして確かめません。3 つの視点が重ならないことが、この分け方の価値です。
そして、この運用に「マージ後の通し実測を受入条件にする」という 1 行を足した理由があります。単体テストがすべて緑の状態で、通し実測でしか見えない穴が続けて出たからです。特定の経路で登録した利用者だけが定期処理の対象から漏れていた。設定を写す箇所が 1 つ抜けていた。送るはずの通知が送られていなかった。どれも単体テストは正しく通っていて、部品を組み合わせて本番と同じ配線で動かして初めて見える穴でした。以来、私たちはテストが緑であることを「完了」とは呼ばず、通しで動いたことを「完了」と呼んでいます。この 1 行は、テストを AI に任せる範囲を広げるほど効いてきます。任せる量が増えるほど、人が「読む」確認は追いつかなくなり、「通しで動く」という事実だけが頼れる根拠になるからです。
明日から始める 4 手順 ── 既存の 1 機能から
最後に、ここまでの内容を、明日から手を動かせる順番にします。新しいプロジェクトを待つ必要はありません。すでに動いている機能を 1 つ選べば、今日から始められます。
手順 1 ── 既存の 1 機能で観点表を出させ、自分の観点表と突き合わせる
すでに本番で動いていて、仕様がそれなりに分かっている機能を 1 つ選びます。仕様(なければ画面の説明)と境界値・異常系のチェックリストを渡し、観点表を出させます。同時に、自分でも 15 分だけ観点を書き出します。2 つを並べて、AI にしか無い行、自分にしか無い行に印を付けます。この差分が、そのまま次の 2 つを教えてくれます。自分のチームが飛ばしがちな観点(AI にしか無い行)と、AI に教えるべき業務の文脈(自分にしか無い行)です。後者は、そのまま次回の観点出しの入力に足します。
手順 2 ── 合格条件と「テストしないこと」を先に書く
観点表に重要度を付け、上位の観点について「この入力のとき、こう動けば合格」を人の言葉で書きます。同時に、今回はテストしない観点を明示的に書きます。「同時操作は今回は手で 1 回確かめて終わり」「管理者以外の権限は対象外」といった形です。これを書かないと、AI は網羅しようとして、テストの本数だけが増えます。テストしないことを決めるのは、リスクを引き受ける判断であり、人がやる仕事です。ここで書いた合格条件は、AI に変えさせない前提で固定します。
手順 3 ── 報告の形を固定する
テストを実行させるときの報告の形を、手順書として 1 枚に書きます。全体の件数と内訳、失敗ごとの場所・期待値・実際の結果・エラー・考えられる原因、そして「テストファイルを変更した場合は変更理由を書く」の 1 行。この 1 枚を、テストを依頼するたびに添えます。最初は面倒に感じますが、3 回目あたりから、報告を読む時間が短くなるはずです。何を判断すればよいかが、報告の形で決まっているからです。
手順 4 ── 修正ループの回数と、止まったときの戻し先を決める
失敗したテストを直させるとき、「何回まで自律的に直してよいか」と「その回数で直らなかったら誰に何を返すか」を決めます。私たちは 3 回にしていますが、数は自分たちで決めて構いません。大事なのは、上限があることと、止まったときの報告の形(残った失敗、試した修正、考えられる原因の候補)が決まっていることです。これが無いと、AI は直し続け、人は「まだやってるのか」と待ち続けます。上限があれば、AI は止まり、人は判断だけを受け取ります。
Livune は、この記事の型──テストの仕事を 4 つに分け、合格条件を人が固定し、作る役・試す役・疑う役を分けて、通し実測を受入条件にする──を自社の開発で毎日回し、企業のエンジニア組織向けにテスト担当を含む担当エージェントの型を研修で配布している会社です。テストの分担をどう設計するかから、ご相談ください。
Livune の AI 導入支援・研修について相談する →よくある質問
テスト自動化ツールは「決めたテストを繰り返し実行する」ための道具で、人が書いたテストを速く・確実に走らせます。AI にテストを任せることは、その手前の「観点を出す・ケースに落とす」と、後ろの「結果を読んで整理する」まで含めて渡すことです。両者は競合せず、組み合わせるものです。AI が観点とケースを出し、自動化ツールが実行を担い、AI が結果を整理し、人が判定する ── この分担が、本文の 4 つの仕事にそのまま対応します。
無くなるのではなく、重心が移ると私たちは考えています。ケースを書く・実行する・結果を集計するという作業の比重は下がります。一方で、業務の文脈からリスクを見抜いて観点の重要度を決める、何をテストしないかを決める、出してよいかを判定する、という仕事の重要度は上がります。本文の表のとおり、4 つの仕事のうち「合否を判定する」は AI に渡さない仕事で、その判定の質が QA の価値そのものになっていきます。
「テストが緑だから正しい」とは信用しないでください。信用してよいのは、期待値を人が仕様から固定し、実装とは別の文脈で書かせ、テストファイルの差分を人が読んだテストです。この 3 条件を満たしていれば、AI が書いたテストは人が書いたテストと同じように扱えます。逆に、実装と同じ会話で書かせて期待値も AI に決めさせたテストは、「今こう動いている」を守っているだけで、「こう動くべき」を守っていません。信用の根拠は、誰が書いたかではなく、どう書かせたかにあります。
むしろ、そういうシステムほど始めやすい領域があります。それは「観点を出す」です。既存のコードや画面の説明を渡して「壊れ方の一覧」を出させると、テストが無いまま長年動いてきた機能のどこが危ないかの地図が手に入ります。そこから重要度の高い観点だけをケースにし、本番と同じ配線を通る検査を 1 本ずつ足していく。全部にテストを書こうとせず、地図を作ってから、痛いところから順に守る ── 本文の手順 1 と手順 2 は、この状況を想定して書いています。